

‘국가대표 AI’, LG·SKT·업스테이지 ‘생존’…모디프, 벤치마크 최고점에도 ‘탈락’

 입력 2026-08-18 17:19:20


LG ‘신뢰성·에이전틱’, SKT ‘추론·산업화’, 업스테이지 ‘효율·NPU’ 강점
평가 영역별 1위 모두 달라…모델 성능·사용성·산업화 종합평가
AAII 최고점 모티프는 활용성서 밀려…3차선 최종 2자리 놓고 정면승부
정부의 ‘독자 인공지능(AI) 파운데이션 모델’ 프로젝트가 LG AI연구원과 SK텔레콤, 업스테이지의 3파전으로 압축됐다. 이번 평가에서는 모델의 절대 성능 뿐만 아니라 신뢰성, 산업 적용 가능성, 실제 사용성, 국산 AI 생태계 기여도 까지 종합적으로 판단해 당락을 갈랐다. 특히 글로벌 벤치마크에서 가장 높은 성적을 낸 모티프테크놀로지스가 탈락하면서 ‘벤치마크 점수=국가대표’라는 공식도 무색케 했다.
과학기술정보통신부와 정보통신산업진흥원(NIPA)은 18일 독파모 2차 단계평가 결과, LG AI연구원과 SKT, 업스테이지가 다음 단계에 진출했다고 밝혔다. 모티프는 4위로 탈락했다.
평가는 벤치마크 40점, 전문가 평가 35점, 사용자 평가 25점으로 구성됐다. 벤치마크 1위와 4위 간 격차는 4.0점, 전문가 평가는 2.4점, 사용자 평가는 5.0점에 그쳤다. 세 영역의 1위 기업도 모두 달랐다. 특정 영역에서 압도한 팀보다 성능과 활용성을 얼마나 균형 있게 확보했느냐가 생존을 결정한 셈이다.
◇ LG ‘신뢰성’·SKT ‘추론’·업스테이지 ‘효율’로 생존
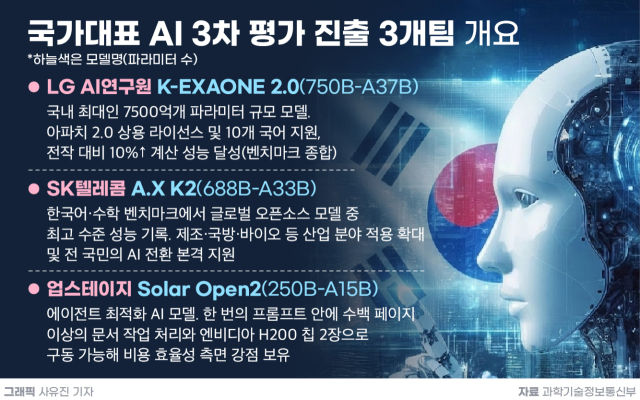
LG AI연구원은 ‘K-EXAONE 2.0’을 통해 모델 체급과 신뢰성을 동시에 입증했다.
7500억개 파라미터로 국내 최대 규모를 구축하면서 전작보다 종합 벤치마크 성능을 10% 이상 끌어올렸다. 특히 환각 억제 관련 지표에서 세계 9위를 기록했고, 전문가 평가에서는 글로벌 국제기구와의 협력 전략과 에이전틱 AI 차별성, 위험관리 체계가 좋은 평가를 받았다. 단순히 큰 모델을 만드는 것을 넘어 신뢰 가능한 대형 AI를 글로벌 시장에 확산할 수 있다는 점이 강점으로 작용했다.
SKT는 추론 성능과 산업 적용 능력이 돋보였다. 6880억개 파라미터 규모의 ‘A.X K2’는 한국어와 수학 영역에서 글로벌 최상위권 성능을 기록했다. 국제수학올림피아드(IMO) 2026 문제 평가에서 금메달 기준 점수를 기록했고 AIME 기반 평가에서도 97.1% 정확도로 공동 최고점을 올렸다. 여기에 국방, 제조, 법무·세무 등 산업 특화 에이전트 적용 가능성을 입증한 점도 높은 평가를 받았다.
업스테이지는 효율성과 실서비스 적용에서 경쟁력을 보였다. 이 회사의 ‘Solar Open2’는 최대 100만 토큰의 컨텍스트 윈도를 지원하면서 엔비디아 H200 GPU 2장으로 구동할 수 있도록 설계됐다. 포털 다음과 Timely 등에 모델을 연계하고 퓨리오사AI의 NPU와 협력한 점도 긍정적으로 평가됐다. 대규모 GPU를 투입하는 체급 경쟁과 달리 모델 효율성과 국산 AI 반도체를 결합한 생태계를 제시한 것이다.
◇ AAII 최고점 모티프 탈락…“성능만으론 부족”
모티프의 탈락은 이번 평가의 성격을 가장 분명하게 보여준다. ‘Motif 3’는 AAII에서 47점을 기록해 전 세계 기업별 최고 모델 가운데 10위에 랭크됐다. 미국과 중국을 제외하면 가장 높은 수준이다. 아키텍처부터 토크나이저, 옵티마이저, 커널까지 자체 개발했다는 점도 기술 독립성 측면에서 의미가 컸다.
그러나 벤치마크 배점은 전체 100점 중 40점에 그쳤다. 정부 설명에 따르면 모티프는 기술력에서는 뛰어난 성과를 냈지만 전문가·사용자 평가 등 활용성과 사용성 측면에서 경쟁 팀보다 상대적으로 낮은 평가를 받았다. 모델 자체의 성능 뿐만 아니라 이를 실제 서비스와 산업 현장, 국내 AI 생태계로 연결하는 능력까지 중시한 평가 구조가 당락을 가른 셈이다.
업계 일각에서 제기됐던 ‘벤치맥싱’ 논란도 평가 결과에 영향을 주지 않았다. 과기정통부가 AAII 운영기관인 아티피셜 애널리시스에 분석을 의뢰한 결과 체계적인 암기나 과적합이 입증될 만한 단서를 찾지 못했다는 답변을 받았다.
류제명 과학기술정보통신부 2차관이 18일 서울 종로구 정부서울청사에서 독자 AI파운데이션모델 프로젝트 2차 단계평가 결과 브리핑을 하고 있다. <출처=연합뉴스>
◇ 3차 평가, 더 치열해진다…최종 2자리 놓고 승부
3차 평가에서는 이번에 관문을 통과한 3개 팀 가운데 최종 2개 팀이 선정된다. LG는 모델 규모와 신뢰성, SKT는 추론과 산업 적용, 업스테이지는 효율성과 국산 AI 반도체 연계라는 서로 다른 무기를 갖고 있어 결과를 예측하기 쉽지 않다.
LG는 현재의 대형 모델 우위를 실제 에이전틱 AI 성능과 글로벌 확산으로 연결하는 것이 과제다. SKT는 수학·한국어 추론 경쟁력을 산업 특화 AI 서비스 성과로 구체화해야 한다. 상대적으로 모델 체급이 작은 업스테이지는 효율성이라는 강점을 유지하면서 절대적인 모델 성능 격차를 얼마나 좁히느냐가 관건이다.
정부가 하반기 B200 GPU 지원 규모를 상반기 약 768장에서 약 1000장으로 확대하는 점도 변수다. 6개월간 1000장을 임차할 경우 팀당 약 400억원, 3개 팀 전체로는 약 1200억원 규모다. 컴퓨팅 자원 지원이 늘어나면서 3개 팀 모두 모델 성능을 추가로 끌어올릴 수 있는 여력이 커졌다.
◇ 정부, ‘소수 승자’ 방식도 재검토…프론티어 AI 지원 확대
정부의 정책 방향도 단순한 최종 승자 선발에서 국내 프론티어 AI 생태계 육성으로 넓히는 분위기다. 예정대로 3차 평가를 진행해 내년 초 최종 2개 팀을 선정하되, 소수 기업만 집중 지원하는 현재 방식 자체는 손질할 가능성이 커졌다.
과기정통부는 글로벌 프론티어 AI 기업과 경쟁할 수 있는 모델을 육성하기 위해 기존 지원 방식을 넘어서는 새로운 지원체계를 관계부처와 논의 중이다. 이번 2차 평가에서 탈락한 모티프까지 글로벌 수준의 기술 경쟁력을 보여준 만큼 순위를 기준으로 유망 기업을 차례로 지원 대상에서 제외하는 방식이 국가 AI 경쟁력 확보에 적절한지에 대한 고민이 반영된 것으로 풀이된다.
류제명 과기정통부 2차관은 “소수 승자만을 뽑는 방식을 탈피해 프론티어 기업에 버금가는 모델 경쟁이 가능하도록 지원 방식을 전면 재편하는 방안을 논의 중으로 정부 예산이 확정되는 대로 구체적 방안을 발표할 것”이라고 말했다.
[CEO스코어데일리 / 김동일 기자 / same91@ceoscore.co.kr]


댓글
[ 300자 이내 / 현재: 0자 ]
현재 총 0개의 댓글이 있습니다.